模型升級後,我幫 AI 寫的規則反而變成絆腳石
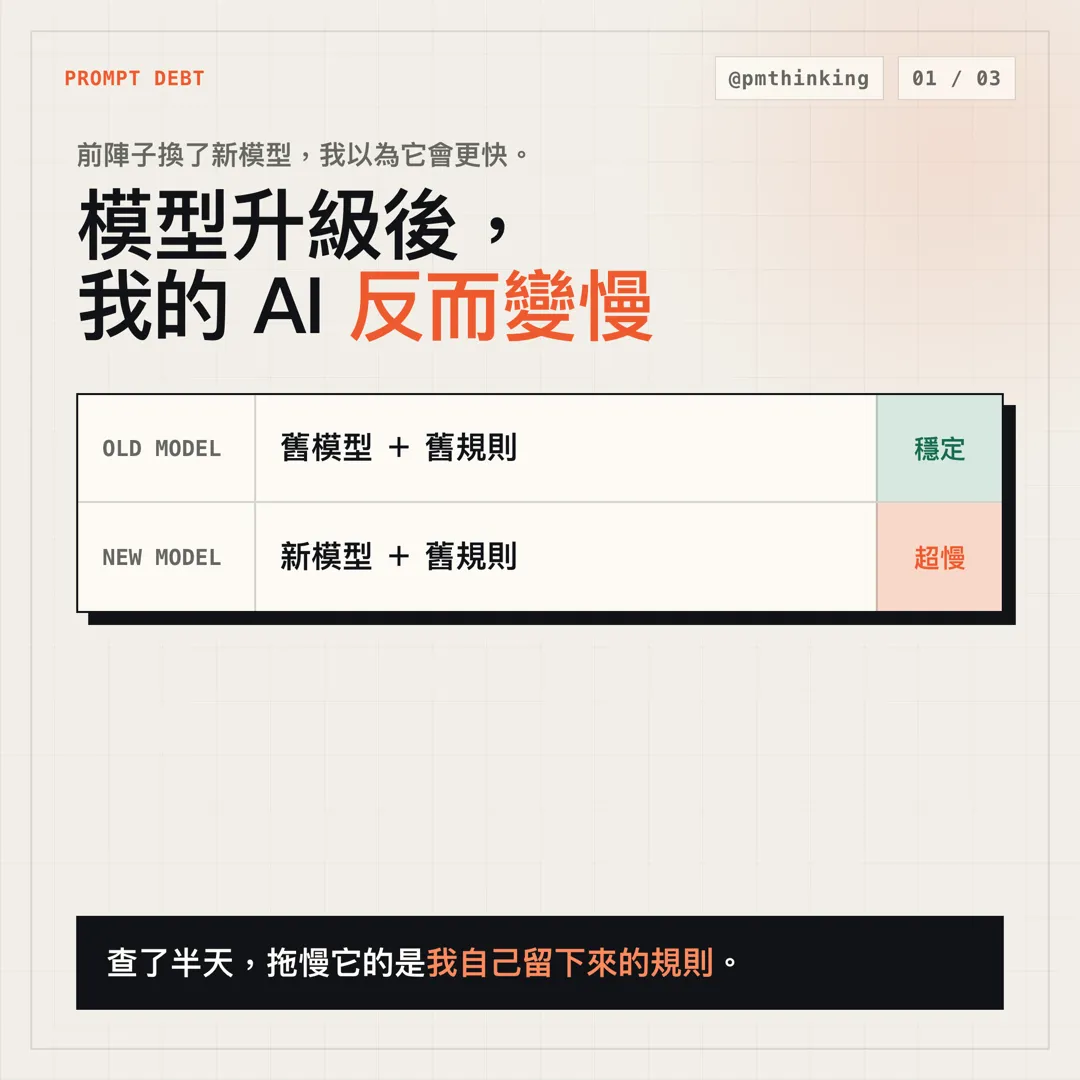
前陣子 Claude、OpenAI 都推出了新模型,試用後突然發現我的 AI 變得超慢。查了半天,發現拖慢它的是我自己寫的規則。
前陣子 Claude、OpenAI 都推出了新模型,試用後突然發現我的 AI 變得超慢。查了半天,發現拖慢它的是我自己寫的規則。
過去半年,我幫 AI 累積了一疊規則檔:哪些事要先查證、輸出用什麼格式、踩過的坑怎麼繞。每一條都是某次它做錯事之後補上的,每個錯誤都有對應的防呆措施跟處理的 SOP。
舊模型配這疊規則,跑得非常穩定。所以升級的時候,我想都沒想就整套沿用。
但剛好問題就出在這裡。
規則也是會過期的
以前模型不夠聰明時,需要外部規則來讓 AI 可以按照流程進行,例如:每步都要回報、先查證再回答、動手前先讀某某檔。
我後來才發現,那些規則其實只適合上一版模型。
舊模型有它的弱點:交代不清會亂做,跑長任務跑到一半會忘記原本的目標。那疊規則就是為了堵住這些洞,一條一條補上去的。
新模型本身就會這些事。但規則還在檔案裡,它讀了就照做:一步能做對的事,還是乖乖走完整套儀式。就像要求一個資深的新同事照實習生的 checklist 工作,每半小時回報一次進度。他不會做錯,但一定變慢,新模型反而沒有幫助到我。
不是只有我遇到
美國有個做 AI 產品的團隊叫「Every」,測 Claude Opus 5 測了一週:模型跟指令吵架、事情做一半就停、跟他們累積的 skills 處不好。最後把既有 skills 全部刪掉重來,反而變順了。
他們找出的其中一條元凶是:一段舊指令要求模型「停下來,等另一個 agent 接手」,但新流程裡那個 agent 根本不存在,模型就真的停在那裡等。刪掉那段,整個 workflow 就恢復正常了。
這個現象有人取了名字,叫 prompt debt:提示詞太老舊、又沒人管理,就會變成開發者的技術債。
我把規則分成兩種
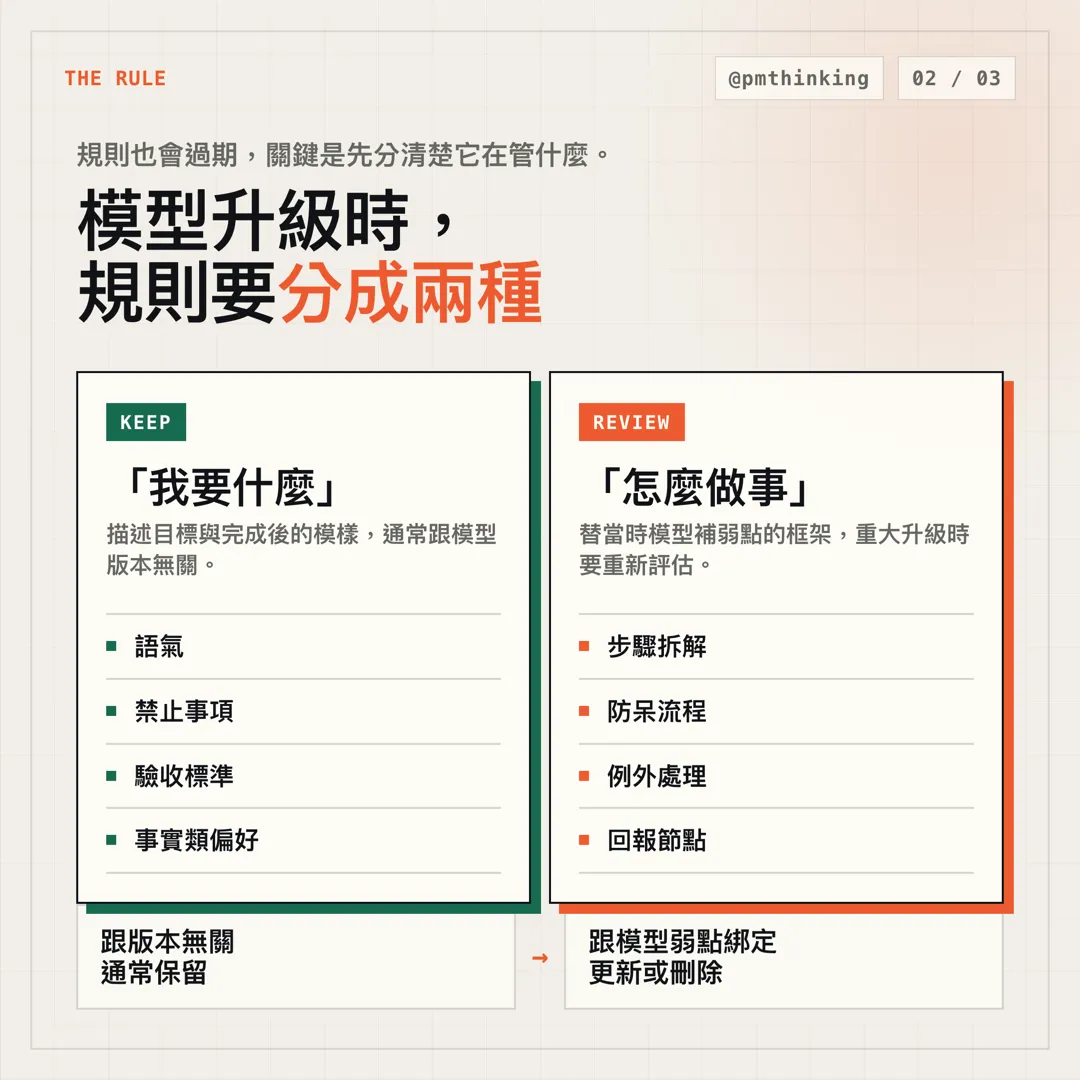
我調整的方法是把規則分成兩種,升級時的處理方式完全不同:
-
描述「我要什麼」的:語氣、紅線、驗收標準、事實類的偏好。重點擺在目標跟任務完成後的模樣,這種跟模型版本無關,升級時直接留。
-
教它「怎麼做事」的:步驟拆解、防呆、為了避免例外狀況寫的步驟。這種是為當時的模型搭的框架,重大升級時要重新評估,看要更新還是刪除。
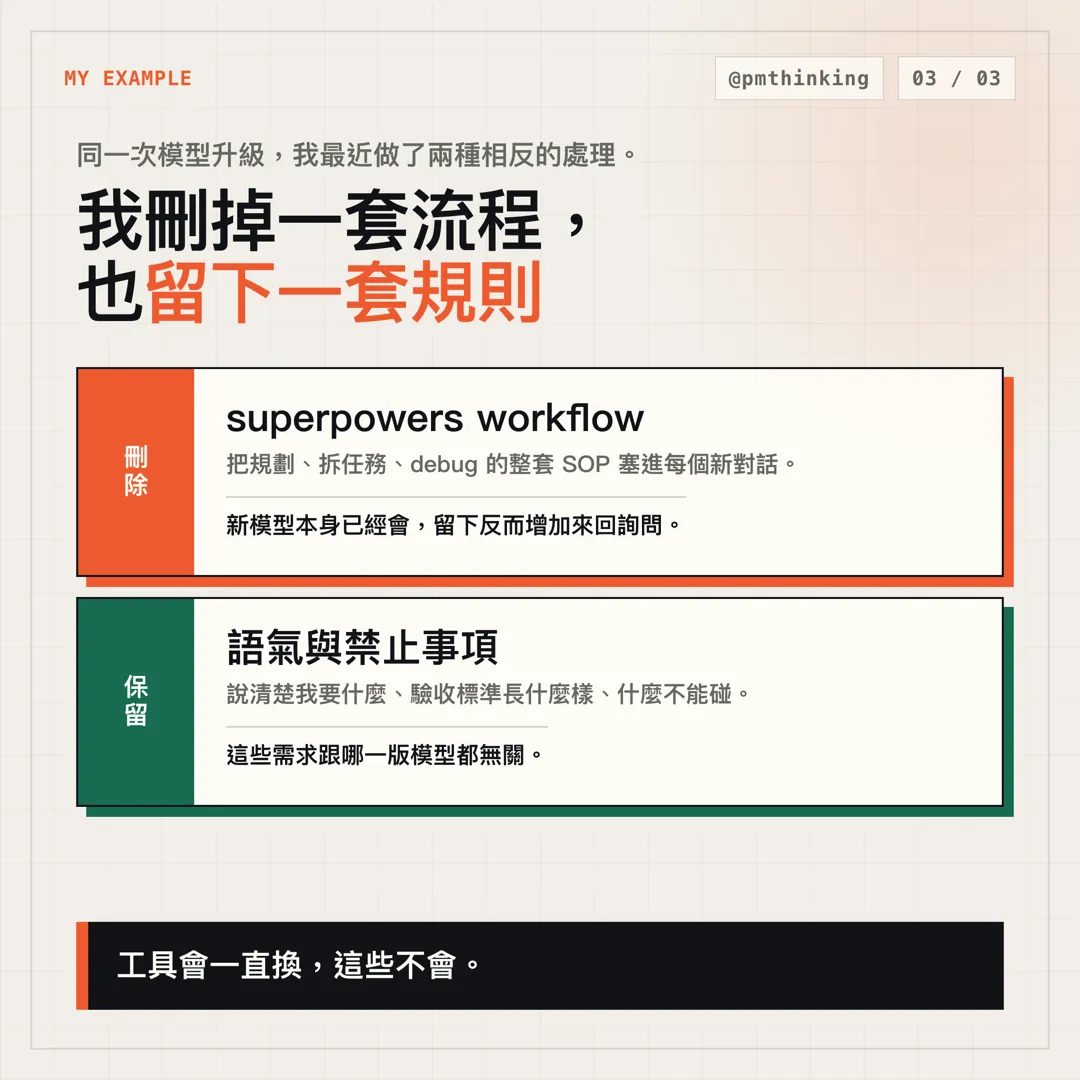
例如我近期把 superpowers 移除了。這是一套滿多人用的工作流 plugin,每開一個新對話,就把整套「怎麼規劃、怎麼拆任務、怎麼 debug」的 SOP 全文塞給模型。
半年前非常好用,但現在的模型變聰明了,留著反而多出很多來回詢問,效率變低。
留下來的則是另一種:我的語氣與禁止事項,裡面寫的是我要什麼、什麼不准碰,跟哪一版模型都無關。
晚進場的人,沒有想像中落後
就像大家說的,現在就是學 AI 最好的時機。新東西更新得非常快,就算晚一點學,也沒有錯過什麼。
這次整理規則檔,讓我對這句話特別有感。我花半年累積的使用技巧,模型一升級就過期了一大半;老手的優勢,每次換代都會被重置一部分。現在才進場的人,跟走了半年的人,其實沒有差那麼多。
真正留得下來的,是跟版本無關的那些:你知道自己要什麼、驗收標準長什麼樣、什麼東西不能碰。工具會一直換,這些不會。
喜歡這篇文章嗎?
訂閱電子報,有新文章時會寄到你的信箱。
電子報即將開放